Kubernetes ayakta kalsa da altyapıya erişim yolu kopabilir
Kubernetes workload'ları ayakta tutar, fakat ağ çökünce altyapıya erişim de gidebilir. Out-of-band yönetim için envanter, tatbikat ve risk notları.
Bu haberde
Bir görüş yazısı, Kubernetes’in workload’ları ayakta tutmasının altyapıyı onarabileceğiniz anlamına gelmediğini savunuyor ve üretim ağından bağımsız bir out-of-band yönetim yolu kurulmasını öneriyor. Yazıya göre router, switch, firewall, WAN veya DNS arızasında mühendisler, düzeltmeleri gereken cihaza ulaşacak yolu da kaybedebiliyor. Yazar, DR (Disaster Recovery) tatbikatlarında normal yönetim yolunun kapalı olduğunun varsayılmasını istiyor ve bu riskin GPU cluster’larında büyüdüğünü söylüyor.
Kısaca Out-of-band yönetim nedir
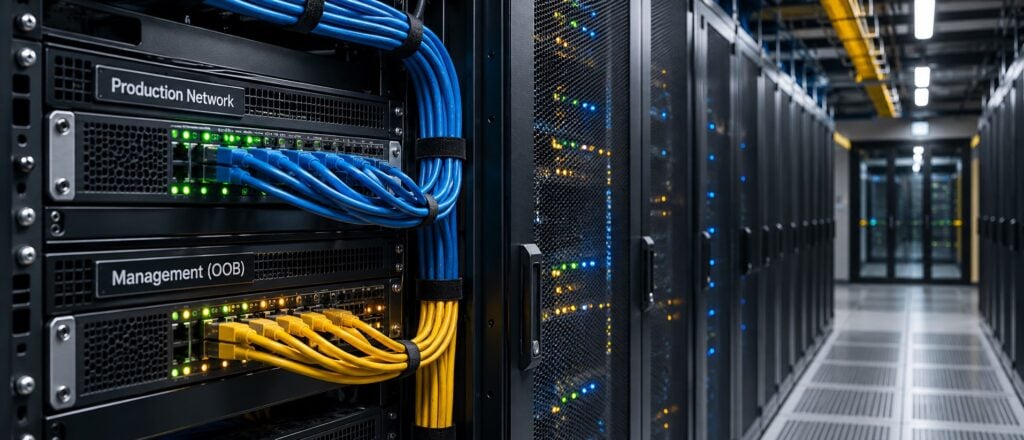
Out-of-band yönetim, sunucu ve ağ cihazlarına üretim trafiğinin geçtiği ağdan ayrı bir kanal üzerinden erişme yöntemidir. Genellikle console server, ayrı yönetim ağı, hücresel bağlantı veya sunucu üzerindeki BMC arayüzleriyle kurulur. Ana ağ çöktüğünde ya da bir yapılandırma hatası erişimi kestiğinde cihazlara ulaşıp onları onarmak için kullanılır. Karşıtı, yönetim trafiğinin üretim ağı üzerinden aktığı in-band yönetimdir.
Workload ayakta, siz dışarıdasınız
Kubernetes çöken container’ı yeniden başlatır, pod’u sağlıklı node’a taşır. Router, switch veya firewall bozulduğunda bunların hiçbiri sizi o cihaza ulaştırmaz.
Üretim ağı arızalandığında, onu onarmak için kullandığınız yol da çoğu zaman aynı ağdan geçiyor. Edge site, colocation veya uzak bir GPU kurulumu işletiyorsanız bu risk sizi de ilgilendiriyor. Yazarın örneğinde on dakikalık bir yapılandırma hatası, sahaya teknisyen göndermeyi gerektiren uzun bir kesintiye dönüşüyor.
Yazar şunları öneriyor:
- Onarılacak yoldan olabildiğince bağımsız bir out-of-band yönetim ağı
- Ağ cihazlarına doğrudan console erişimi
- Alternatif WAN veya hücresel bağlantı
- Birincil ağa bağlı kalmadan erişilebilen, korunan kimlik bilgileri
- Normal management path’in kapalı varsayıldığı tatbikatlar
Out-of-band yönetim için bağımlılık envanteri
Yeni bir şey kurmadan önce bugünkü recovery path’inizin neye dayandığını çıkarın. Bir mühendisin arıza anında firewall’a ulaşmak için attığı adımları sırayla yazın. Her adımın arkasında hangi ağ ve hangi servis var, not edin.
Tipik zincir VPN, bastion host, SSO, vault ve DNS’ten oluşur. Bu zincirde üretim ağından geçen tek bir halka varsa, out-of-band yönetim kâğıt üzerinde kalır. Console server’ınız ayrı hatta bağlı olabilir, fakat parolası yalnızca üretim ağındaki bir vault’ta duruyorsa hatta bağlanır ve oturum açamazsınız.
Aynı soruyu Kubernetes’te kubeconfig için de sorun. API server endpoint’i hangi ağdan erişiliyor, adı DNS ile mi çözülüyor? Kaynak DNS’i de olası arıza noktaları arasında sayıyor. Aktif context’in hangi adrese gittiğini şöyle görebilirsiniz:
kubectl config view --minifyÇıkan server adresi yalnızca üretim ağından erişilebiliyorsa, kesinti anında kubectl de elinizden gider.
Tatbikatta management path’i kesin
Çoğu DR testi workload’ların failover yapıp yapmadığına bakar. Yazar, normal yönetim yolunun hiç olmadığı senaryonun da denenmesini istiyor. Bunu düşük riskli bir sitede başlatın. Yalnızca out-of-band kanalları kullanarak bir switch’e bağlanın, yapılandırmayı okuyun ve yanıt vermeyen bir cihazın gücünü uzaktan kapatıp açın.
Tatbikatta şunları kayda geçirin:
- Console’a ilk bağlantıya kadar geçen süre
- Break-glass kimlik bilgisine kimin, hangi onayla ulaştığı
- Kontrolü geri alma sırasının yazılı olup olmadığı
Platform, SRE, network ve security ekiplerini aynı masaya alın. Hücresel modemin SIM’ini, console server’ın firmware’ini ve break-glass parolasının rotasyonunu çoğu zaman farklı kişiler yönetir. Bu işlerin her birinin sahibini tatbikat notuna isimle yazın.
GPU cluster’larında kesinti dakikası pahalı
Kubernetes GPU cluster’larının kontrol katmanı oldukça, ağ arızası training job’larını, inference servislerini ve storage erişimini birlikte durdurabiliyor. Bu ortamlarda kesintinin her dakikasında pahalı donanım boşta bekliyor.
Out-of-band yönetim bütçesini gerekçelendirirken buradan başlayın. Hem uzak hem de yüksek kullanım beklenen site sıranın en başına gelir. Merkezi veri merkezinde yakında bir mühendis olabilir, uzak bir GPU sitesinde olmayabilir.
Ek yolun kendi riski
Ayrı bir yönetim ağı yeni bir saldırı yüzeyi açar. Console server ve hücresel bağlantı, saldırgana cihazın yönetim arayüzüne doğrudan inen bir kapı açar. Bu yolu en az üretim kadar sıkı koruyun: varsayılan parolaları değiştirin, erişimi allowlist ile daraltın, oturumların log’unu tutun.
Yazarın bir uyarısı daha var: karmaşıklık kurtarmanın aleyhine çalışır. Out-of-band tarafına kendi SSO’su ve kendi otomasyonu olan ikinci bir platform kurarsanız, arıza anında onun bağımlılıkları da devreye girer. Console, ayrı hat, erişimi korunan kimlik bilgisi ve yazılı geri alma sırası ile işe başlayın; gerisini tatbikat sonuçları belirlesin.