OpenTelemetry Kafka receiver’da yavaş tenant diğerlerini durdurmuyor
OpenTelemetry Kafka receiver artık partition başına worker ve tenant başına queue sınırıyla yavaş bir tenant'ın diğerlerini durdurmasını engelliyor.
Bu haberde
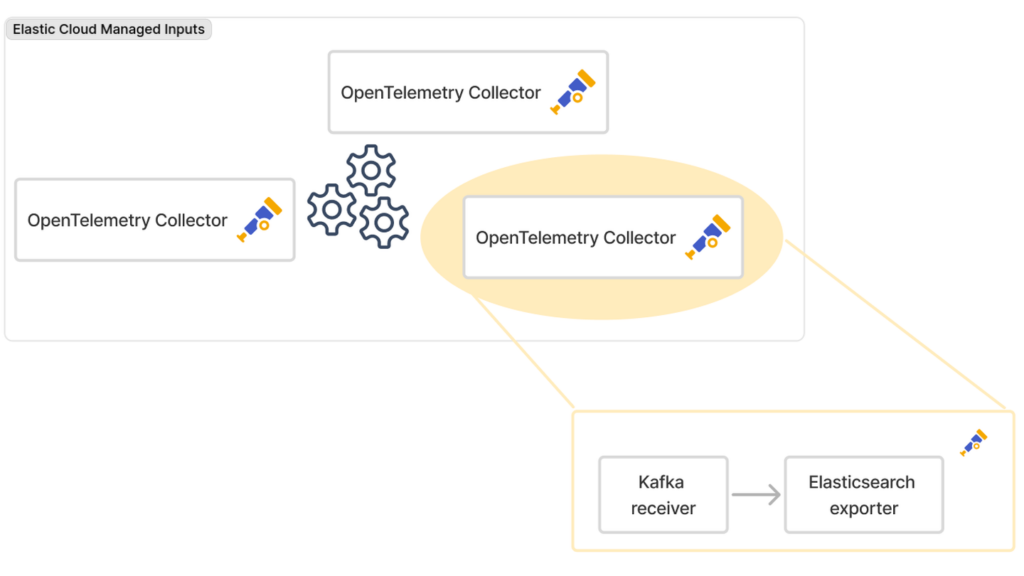
Elastic, OpenTelemetry Kafka receiver için iki değişiklik geliştirip projeye katkı olarak gönderdi. Her Kafka partition’ı artık kendi worker’ını alıyor, yeni bir processor da tek bir tenant’ın exporter sending queue’sunda tutabileceği slot sayısını sınırlıyor. Elasticsearch cluster’ı yavaşlayan tenant yalnızca kendini geciktiriyor, kayıt düşürülmüyor ve teslimat at-least-once kalıyor.
OpenTelemetry Collector nedir, ne işe yarar?
OpenTelemetry Collector, log, metric ve trace verisini toplayıp işleyen ve bir veya daha fazla backend’e ileten açık kaynak bir agent’tır. Pipeline’ı receiver, processor ve exporter bileşenlerinden kurulur. Hem uygulamaların yanında agent olarak hem de merkezi gateway olarak çalıştırılabilir. Fluent Bit ve Vector benzer işler için kullanılan alternatiflerdir.
Tek consumer, tek queue, tek darboğaz
Bir collector’da birden fazla müşterinin veya ekibin verisini Kafka’dan okuyup farklı hedeflere yazıyorsanız bu değişiklik sizi doğrudan ilgilendiriyor. Elastic’in tarif ettiği kurulumda tek consumer group, wildcard pattern ile bütün tenant topic’lerine abone oluyordu. Fetch edilen kayıtlar tek döngüde sırayla işleniyor, hepsi exporter’ın paylaşılan sending queue’suna düşüyordu.
Bir tenant’ın Elasticsearch cluster’ı yavaşlayınca queue o tenant’ın kayıtlarıyla doluyor. Queue dolunca receiver döngüsü bloklanıyor ve sağlıklı tenant’lar da duruyor. Klasik noisy neighbor: sorun tek bir backend’de, gecikme her yerde.
OpenTelemetry Kafka receiver’da iki katmanlı izolasyon
Çözüm iki parçalı ve parçalar birbirini tamamlıyor:
- Partition worker: consumer’a atanan her partition kendi worker’ını alıyor. Yavaş tenant’ın worker’ı duruyor, diğerleri fetch etmeye devam ediyor.
- Tenant limiter processor: receiver ile exporter arasına giriyor ve her tenant’ın queue’da tutabileceği slot sayısını sınırlıyor.
Yalnızca ilk değişikliği alırsanız sorun ertelenir, çözülmez. Worker’lar ayrılsa da queue ortak kalıyor ve yavaş tenant onu yine doldurabiliyor. Elastic de partition worker’ların yetmediğini yazıyor.
Bir varsayım gözden kaçabilir. Elastic’in yapısında her topic tek bir tenant’a ait ve partition bazlı izolasyon bu eşleşmeye dayanıyor. Tek bir topic’e birden fazla tenant yazıyorsanız aynı partition’da farklı tenant’ların kayıtları karışır, partition worker onları ayıramaz. İşe topic tasarımınızı kontrol ederek başlayın.
Limiter cap’i nasıl büyütüp küçültüyor
Limiter statik pay dağıtmıyor. Her tenant küçük bir cap ile başlıyor, başarılı her istekle cap kademeli olarak büyüyor. Yavaş yanıt veya retryable hata gelince cap hemen yarıya iniyor. Üst sınır yapılandırmadan geliyor. Mantık, TCP’nin tıkanıklık kontrolüne benziyor: yavaş tırman, sorunda sert geri çekil.
Bu davranıştan iki pratik sonuç çıkıyor. Restart veya rebalance sonrasında her tenant küçük cap ile başlayacağı için birikmiş lag ilk dakikalarda yavaş erir; bunu arıza saymayın. Sık retryable hata dönen bir backend de o tenant’ı sürekli düşük payda tutar.
Kayıt düşürülmüyor. Cap dolunca o tenant’ın worker’ı bekliyor ve yalnızca o partition’ın fetch’i duruyor, yani yavaş tenant’ın sorunu Kafka’da consumer lag olarak birikiyor. Topic retention süreniz en uzun backend kesintisinden kısaysa veri Kafka’da kaybolur. Retention’ı buna göre ayarlayın.
Max_in_flight ayarlarında bellek hesabı
partition_processing.max_in_flight.records bir worker’ın aynı anda kaç kaydı unmarshal edip pipeline’a verebileceğini belirliyor. Tek başına bellek sınırı koymuyor. Elastic’in örneğiyle 64 kayıt, küçük kayıtlarda önemsiz bir yük, büyük kayıtlarda 2 GB olabilir.
Bu yüzden partition_processing.max_in_flight.bytes ayarını da birlikte verin. Bu sınırın partition başına mı yoksa toplamda mı uygulandığını sürüm belgesinden doğrulayın. Partition başınaysa değeri pod’a düşen partition sayısıyla çarpıp container bellek limitinizle karşılaştırın. Rebalance sonrasında bir pod’a düşen partition sayısı artabilir.
Eşzamanlılık tekrar eden kayıtlar getiriyor
Offset yalnızca fetch sırasındaki kesintisiz önek boyunca işaretleniyor. Bitmiş ama işaretlenmemiş kayıtlar crash veya partition reassignment sonrasında yeniden gönderiliyor. max_in_flight.records değerini yükselttikçe bu pencere de büyür. Backend’iniz tekrar eden dokümanı ayıklamıyorsa log sayıları ve metric toplamları rebalance sonrasında şişebilir; alarm eşiklerinizi buna göre gözden geçirin.
Kendi kurulumunuzda ilk adım
Önce sorunun sizde olup olmadığını ölçün. Partition bazında lag’i Kafka’nın standart aracı gösteriyor:
kafka-consumer-groups.sh --bootstrap-server <broker>:9092 --describe --group <consumer-group>Bir tenant’ın lag’i büyürken diğer tenant’ların lag’i de aynı anda artıyorsa noisy neighbor yaşıyorsunuz. Değişiklik devreye girdikten sonra yalnızca yavaş tenant’ın lag’i artmalı.
Elastic, yazıda yeni processor’ın adını ve değişikliklerin hangi collector sürümüne girdiğini vermiyor. OpenTelemetry Kafka receiver sürümünü yükseltmeden önce release notlarında partition_processing ayarlarını arayın ve limiter’ın tenant’ı hangi bilgiden tanıdığını belgeden doğrulayın.