ML platformunu Kubernetes’te çalıştırmak onu native yapmıyor
Workload'ı cluster'a taşımak Kubernetes-native ML için yeterli değil. Training, model ve deployment adımları custom resource ve controller ile yönetilmeli.
Bu haberde
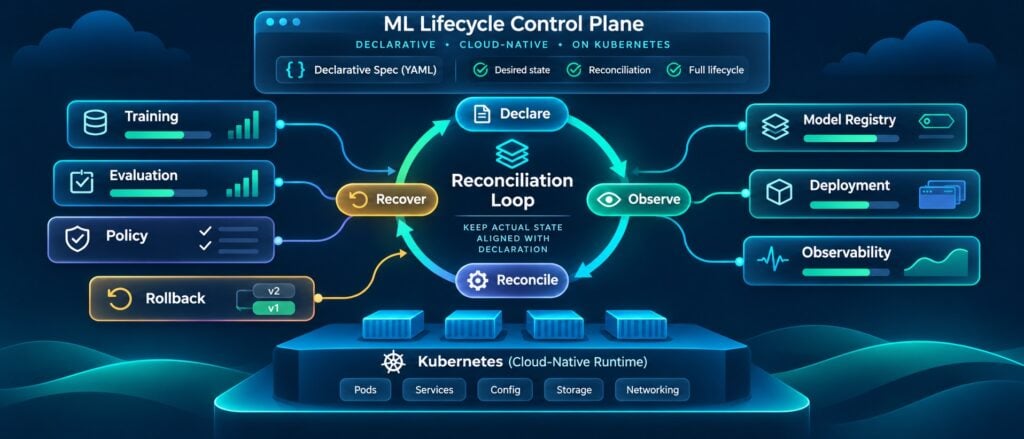
Uber’in Michelangelo AI platformunda çalışmış bir yazar, ML iş yüklerini Kubernetes’e taşımanın Kubernetes-native ML anlamına gelmediğini savunuyor. Yazara göre training, evaluation, registration, deployment ve rollback adımları hâlâ ayrı servis API’leri, veritabanları ve özel script’lerle yönetiliyor. Önerdiği çözüm, bu yaşam döngüsünü custom resource ve controller’larla reconciliation loop’a bağlamak; Michelangelo’nun modüler control plane’i de açık kaynak olarak yayımlandı.
Kısaca Reconciliation loop nedir
Reconciliation loop, bir controller’ın istenen durumu gözlenen durumla sürekli karşılaştırıp aradaki farkı kapatmak için harekete geçtiği döngüdür. Kubernetes’teki Deployment, ReplicaSet gibi yerleşik kaynaklar bu modelle çalışır. Platform ekipleri custom resource ve kendi controller’larını yazarak aynı modeli veritabanı, sertifika veya ML yaşam döngüsü gibi alanlara taşır.
Model rollback’ini bir script çalıştırıp bir veritabanı kaydını güncelleyerek yapıyorsanız yazı sizin platformunuzu anlatıyor. Yazarın ayrımı net: Kubernetes compute’u çalıştırıyor, yaşam döngüsünü ise özel yapıştırıcı kod yönetiyor.
Bu ayrım arıza anında ortaya çıkıyor. Pod yeniden başlar, fakat yarıda kalan bir canary geçişini kimse yeniden denemez.
Önerilen mimari dört maddede
- Training run, model, evaluation ve deployment ayrı custom resource oluyor. Aralarındaki referanslar lineage’ı taşıyor.
- Controller istenen durumu gözlenen durumla sürekli karşılaştırıyor. Yazının örneğinde 42 numaralı model sürümü trafiğin yüzde 10’unu almalı; controller canary rollout başlatıyor, health sinyallerini değerlendiriyor ve status’u güncelliyor.
- Status condition’ları her aşamada aynı dili konuşuyor: pending, progressing, ready, degraded, blocked.
- Control plane eğitim ve inference (çıkarım) motorlarının yerine geçmiyor. Adapter’lar intent’i motorun anladığı kaynağa çeviriyor, sonuç yine yaşam döngüsü modeline dönüyor.
En çok son madde işe yarıyor. Execution engine değiştiğinde kullanıcıya dönük API aynı kalıyor.
Kubernetes-native ML için ilk kontrol
Şu soruyla başlayın: üretimdeki bir modelin hangi training run’dan ve hangi veri setinden geldiğini cluster’dan okuyabiliyor musunuz? Cevap için başka bir servise gidiyorsanız lineage cluster dışında yaşıyor.
Cluster’da tanımlı CRD’lere bakmak hızlı bir envanter çıkarır:
kubectl get crd
kubectl api-resources
Listede yalnızca job ve iş akışı tipleri varsa, model ile deployment arasındaki ilişkiyi Kubernetes bilmiyor. Rollback yolunuza da bakın. kubectl rollout undo Deployment’ı geri alır, fakat model kaydı ve trafik payı başka bir sistemde tutuluyorsa ikisi birbirinden kopabilir.
Her kavrama CRD açmayın
Yazar burada açık bir sınır çiziyor. Büyük model dosyaları, log’lar, trace’ler ve ayrıntılı evaluation sonuçları kendi repolarında kalmalı. Custom resource yalnızca intent, referans ve kısa status taşımalı.
Gerekçesi operasyonel: etcd büyük nesneler için tasarlanmadı. Status alanını şişirdiğinizde her güncelleme API server’a yük bindiriyor ve controller’ların watch trafiği artıyor.
Pratik ölçüt iki soru. Kaynak tek bir process’ten uzun yaşıyor mu, birisi veya bir otomasyon status’unu izleyecek mi? İkisine de hayır diyorsanız o kavram bir fonksiyon çağrısıdır, CRD değil.
Bedel: her CRD uzun vadeli bir sözleşme
Yazara göre API’nin uzun vadeli kontrat olacak kadar oturmuş olması gerekiyor. Bunun karşılığı açık: CRD şemasını yayımladıktan sonra web arayüzü, CLI ve AI agent’lar ona bağlanır. Şemayı sürüm atlatarak değiştirmek conversion webhook ve geçiş planı gerektirir.
Controller yazmak işin kolay kısmı. Onu işletmek, observability eklemek ve admission policy’lerini meşru istekleri bloklamadan ayarlamak da size ek yük getiriyor.
Küçük başlayın. İlk aday model deployment: hangi sürüm, ne kadar trafik, hangi condition’da. Training ve evaluation kaynaklarını bu kaynak oturduktan sonra ekleyin. Michelangelo’nun açık kaynak control plane’i kaynak sınırlarının nereye çizildiğini gösteren iyi bir referans, fakat Uber ölçeği için tasarlandı.
Prompt ve agent’lar aynı listeye giriyor
Generative ve agentic AI’da modelin yanına prompt’lar, tool’lar, policy’ler, benchmark suite’leri ve trace’ler ekleniyor. Yazarın sorduğu sorular değişmiyor: sisteme ne yapmasını söyledik, hangi sürüm ve girdileri kullandı, evaluation’dan geçti mi, geri alabilir miyiz?
Prompt değişikliği de bir release. Versiyonu ve evaluation sonucu kaydedilmeden üretime çıkıyorsa model için kurduğunuz lineage yarım kalır. Kubernetes-native ML yaklaşımını prompt ve agent yapılandırmasına da uygulamak istiyorsanız, önce bunları git’te versiyonlayın ve deployment kaynağından referansla bağlayın.