AlloyDB, Iceberg tablolarını canlı veriyle tek sorguda birleştiriyor
AlloyDB Iceberg desteği preview'da. Sync ve Lakehouse federation GA oldu. Üç yolun farkı, kapasite riski ve maliyet ayarları bu yazıda.
Bu haberde
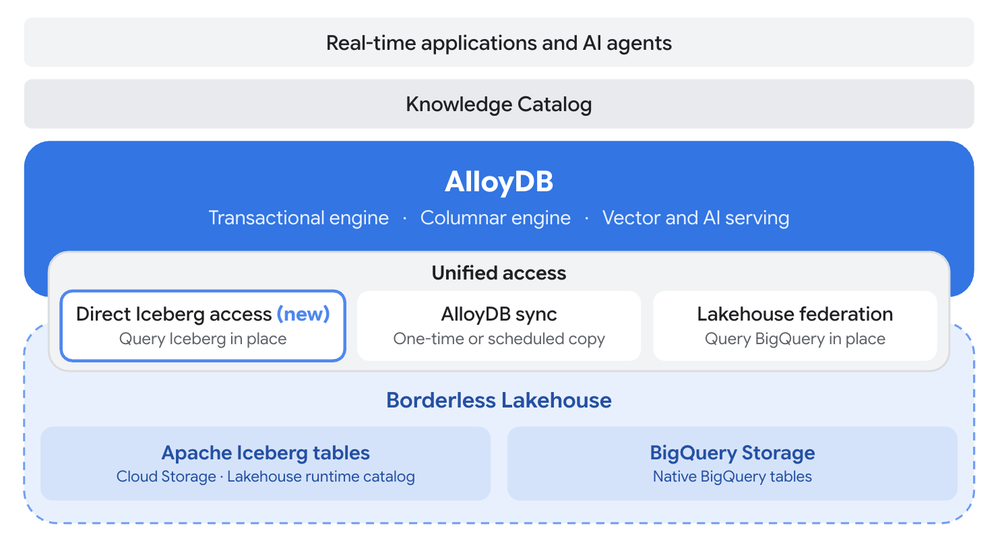
Google Cloud, AlloyDB Iceberg desteğini preview olarak açtı: AlloyDB for PostgreSQL artık Cloud Storage’daki Apache Iceberg tablolarını doğrudan okuyup canlı tablolarla tek SQL sorgusunda join edebiliyor. Aynı duyuruda BigQuery verisini AlloyDB’ye kopyalayan AlloyDB sync ve BigQuery tablolarını yerinde sorgulayan Lakehouse federation GA oldu.
Apache Iceberg nedir, ne işe yarar?
Apache Iceberg, büyük analitik veri setleri için geliştirilmiş açık bir tablo formatıdır. Nesne depolamadaki dosyaları şema, partition ve snapshot bilgisiyle birlikte tablo olarak yönetir. Spark, Trino, Flink ve bulut veri ambarları gibi farklı motorlar aynı Iceberg tablosunu okuyup yazabilir. Lakehouse mimarilerinde sık kullanılır; Delta Lake ve Apache Hudi benzer amaçlı alternatiflerdir.
AlloyDB for PostgreSQL nedir, ne için kullanılır?
AlloyDB for PostgreSQL, Google Cloud’un PostgreSQL uyumlu yönetilen veritabanı hizmetidir. İşlemsel iş yüklerini hedefler ve analitik sorgular için columnar engine içerir. Mevcut PostgreSQL uygulamaları büyük ölçüde değişmeden taşınabilir. Google Cloud içindeki alternatifi Cloud SQL for PostgreSQL, diğer bulutlardaki karşılığı Amazon Aurora PostgreSQL gibi servislerdir.
Üç yol, verinin nerede durduğuna göre
PostgreSQL üzerinde çalışan bir uygulamanın analitik geçmişe erişmesi için şimdiye kadar çoğunlukla ETL pipeline’ı gerekiyordu. Google bu duyuruyla o pipeline’ın yerine üç seçenek koyuyor. Hangisini seçeceğiniz verinin konumuna ve okunma sıklığına bağlı:
- Veri Cloud Storage’da Iceberg formatındaysa ve uygulama onu canlı tablolarla birleştiriyorsa: doğrudan Iceberg erişimi.
- Tablo her istekte okunuyor ama seyrek değişiyorsa: AlloyDB sync.
- Geçmiş zaten native BigQuery tablolarındaysa ve işlem yükünü BigQuery’ye bırakmak istiyorsanız: Lakehouse federation.
Yalnızca ilki preview aşamasında. Sync ve federation GA olduğu için üretim planına şimdiden girebilir.
AlloyDB Iceberg sorguları uygulamayla aynı instance’ta
Google bunu avantaj olarak anlatıyor: reader instance’ı ayrıca yönetmiyorsunuz. Kapasite planlayan biri için aynı cümle başka bir şey söylüyor. Beş yıllık işlem geçmişini tarayan bir aggregation, OLTP trafiğiyle aynı CPU ve belleği paylaşıyor. Columnar engine taramayı hızlandırıyor, fakat yükü ortadan kaldırmıyor.
AlloyDB Iceberg join’lerini ilk aşamada yoğun saatlerin dışında ve dar filtreli sorgularla deneyin. Iceberg sorgusu çalışırken ve çalışmazken uygulamanın gecikme yüzdeliklerini karşılaştırın.
Tablo kaydı tek seferlik. Google’ın örneği şöyle:
CREATE TABLE transaction_history (
  customer_id BIGINT, category TEXT, amount NUMERIC, ts TIMESTAMPTZ)
USING iceberg
WITH (uri = 'gs://my-bucket/warehouse/payments/transaction_history');
Kayıttan sonra tablo diğer PostgreSQL tabloları gibi davranıyor. Google, agent’ların yalnızca AlloyDB’de verdiğiniz tablo ve izinlerle çalıştığını söylüyor, yani bir fraud agent’ına beş yıllık geçmişi açıyorsanız sınırı PostgreSQL rolüyle çiziyorsunuz:
GRANT SELECT ON transaction_history TO fraud_agent;Google, 1 TB’lık veri setindeki aggregation sorgularında Amazon’un PostgreSQL uyumlu servisinden 7 kata, açık kaynak PostgreSQL extension’ından 3,5 kata kadar daha hızlı olduğunu iddia ediyor. Test Google’ın kendi testi; extension’ın adı ve sorgu seti duyuruda yok. Karar vermeden önce kendi Iceberg tablolarınızla ölçün.
Sync’te tazelik bir interval değeri
Sync kopyası yerel bir AlloyDB tablosu. Index ekleyebilir, read pool’dan servis edebilir, columnar engine ve vector search ile kullanabilirsiniz. Okuma gecikmesi açısından en hızlı seçenek bu.
Bedeli tazelik. Kopya, son refresh anındaki veri kadar güncel. Interval’ı teknik tercihten değil iş kuralından türetin:
SELECT alloydb_sync.create_bq_sync_table(
  'my-project.risk.merchant_risk_scores',
  'merchant_risk_scores',
  INTERVAL '1 hour');
Risk skoru gece bir kez hesaplanıyorsa saatlik refresh gereksiz iş üretir. Veri dakikalar içinde değişiyorsa sync yanlış araç; bu durumda yerinde okuma veya federation daha doğru. Kopya yerel tablo olduğu için AlloyDB depolamasında da yer tutar.
Federation’da faturayı hangi proje ödüyor
Federation’da AlloyDB filtre, aggregation ve limit’leri BigQuery’ye itiyor. İşlemi BigQuery yapıyor, AlloyDB’ye yalnızca sonuç dönüyor. Her istekte federation sorgusu çalıştıran bir uygulama, BigQuery’de sürekli sorgu yükü üretir.
Google iki ayar veriyor: sorguların hangi projeye faturalanacağı ve hangi rollerin federation kullanabileceği. İkisini de ilk kurulumda belirleyin. Uygulama ekibiyle veri ekibinin bütçesi ayrıysa maliyetin nereye düşeceğini canlıya çıkmadan netleştirin; rol kısıtıyla da herkesin uygulama bağlantısı üzerinden BigQuery’ye sorgu atmasını engelleyin.
Denemeden önce PostgreSQL 18
Doğrudan Iceberg erişimi PostgreSQL 18 instance’ında etkinleşiyor. Instance’ınızın sürümünü kontrol edin:
SELECT version();Daha eski bir major sürümdeyseniz üretim instance’ını yükseltmeyin, test için PostgreSQL 18 ile yeni bir instance açın. Özellik preview olduğu için sözdizimi GA’ya kadar değişebilir; Iceberg tablo tanımlarını migration script’lerinde tutun ki yeniden kayıt tek komutla yapılabilsin.