AlphaEvolve ile agent skill’lerini gerçek görevlerde optimize etmek
Google, agent skill optimizasyonu için AlphaEvolve ve Harbor'ı birleştirdi; Terminal-Bench 2.0'da en iyi skill zaman sınırı etrafında kuruldu.
Bu haberde
Google Cloud, agent skill optimizasyonu için AlphaEvolve’u Harbor ile birleştiren bir döngü anlattı: Gemini skill metnini yeniden yazıyor, Harbor gerçek bir coding agent’ı bu skill ile Terminal-Bench 2.0 görevlerinde çalıştırıyor. OpenCode ve Gemini 3.8 Flash ile yapılan ölçümde elle yazılmış baseline skill ölçülebilir bir fark yaratmadı; AlphaEvolve birkaç iterasyonda yüzde 5’lik iyileşme getirdi.
AlphaEvolve nedir, ne işe yarar?
AlphaEvolve, Google’ın Gemini modellerini evrimsel bir search döngüsüyle birleştiren kod optimizasyon agent’ıdır. Model, bir programın işaretlenmiş bölümleri için yeni sürümler önerir; kullanıcının yazdığı bir evaluator bu sürümleri puanlar ve yüksek puanlı olanlar sonraki turlara taşınır. Algoritma keşfi ve kod iyileştirme işlerinde kullanılır, Google Cloud üzerinden erişilebilir.
Ölçülmemiş skill dosyaları
Coding agent’larınız için SKILL.md yazıyorsanız ilk bulgu rahatsız edici. OpenCode, Gemini 3.8 Flash ile Terminal-Bench 2.0 görevlerinde denemelerin yaklaşık üçte ikisini geçti. Skill olmadan da sonuç neredeyse aynıydı.
Dikkatle yazılmış bir checklist, agent’ın davranışını ölçülebilir biçimde değiştirmedi. Repo’nuzdaki skill dosyalarını hiç benchmark’a sokmadıysanız etkilerini bilmiyorsunuz. “Önce oku, hatayı yeniden üret, küçük adımlarla ilerle” türü öğütler, modelin zaten yaptığı şeyi tekrar ediyor olabilir.
Agent skill optimizasyonu döngüsü
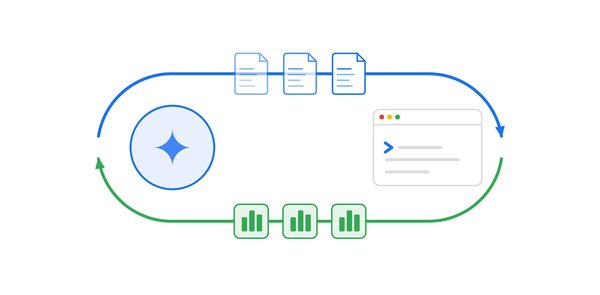
Google’ın kurduğu yapı dört parçadan oluşuyor:
- Skill metni bir seed programda iki marker arasına konuyor; Gemini yalnızca bu bloğu yeniden yazıyor.
- Harbor, agent’ı her aday skill ile gerçek görevlerde çalıştırıyor ve her denemeyi kendi container’ında yürütüyor.
- Her aday, baseline skill ile aynı görevlerde ve aynı anda koşuyor; skor ikisinin farkı.
- Kazanan skill, search’ün hiç görmediği görevlerde son kez sınanıyor.
Seed programın iskeleti kısa:
def build_skill() -> tuple[str, str]:
    # EVOLVE-BLOCK-START
    description = ("Solve engineering tasks in a Linux terminal: ...")
    body = r"""# Terminal task solver ..."""
    # EVOLVE-BLOCK-END
    return description, body
AlphaEvolve Google Cloud’da çalışıyor ve kodunuzu çalıştırmıyor. Elindeki tek bilgi, evaluator’ınızın döndürdüğü skor ve notlar. Bu yüzden iş evaluator’da yoğunlaşıyor. Başarısız olan veya timeout’a düşen görevler için yazdığınız kısa notlar, Gemini’nin bir sonraki sürümü yazarken kullandığı tek geri bildirim.
Baseline’ı aynı anda koşturmanın nedeni
Agent skorları gürültülü. Google’ın erken denemelerinde aday skorlarındaki varyansın büyük kısmını model latency’si açıkladı. Aday ile baseline’ı farklı saatlerde çalıştırırsanız, API’nin o saatteki yavaşlığını skill’in başarısızlığı sanırsınız.
Bu yöntem AlphaEvolve olmadan da işe yarar. Bir system prompt veya skill değişikliğini karşılaştırırken iki sürümü aynı görev setinde, aynı zaman penceresinde çalıştırın. Mutlak pass oranı yerine farkı raporlayın ve görevlerin bir kısmını en baştan search dışında tutun.
Search’ün bulduğu zayıflık: zaman sınırı
Evaluator notlarına göre denemelerin yaklaşık üçte biri zaman sınırına takıldı. AlphaEvolve’un en iyi skill’i de tamamen bunun etrafında kuruldu. Hedef yola erkenden çalışan bir artifact yazılıyor ve kod iyileştirilirken son geçen sürüm diskte tutuluyor. Testler yeşile döndüğü anda agent duruyor.
Daha öğretici sayı başka yerde. Cevapları içeren skill, dev görevlerde 33 puan ekledi. Google’ın hipotezine göre modeller kodlama işine zaten ayarlı, bu yüzden genel tavsiyenin ekleyeceği pek bir şey kalmamış. Fark, agent’ın kendi başına bilemeyeceği bilgiden geliyor.
Kendi skill’lerinizi bu ölçüte göre ayıklayın. Proje özelindeki build komutu, test dizini, ortam kısıtı veya zaman bütçesi gibi bilgiler kalsın. Modelin zaten uyguladığı genel çalışma disiplinini anlatan bölümler büyük olasılıkla skoru değiştirmiyor.
Uzun search için altyapı hazırlığı
Kaynağa göre döngüyü kurmak, onu çalışır tutmaktan kolay. Harbor GKE üzerinde deneme başına bir pod ile koştu ve tek bir search binlerce agent denemesi yaptı. Yaklaşık 10 saat sonra search hiçbir yeni adayı skorlayamaz hale geldi:
- Latency kontrolü, model yanıtları yavaşken tüm değerlendirmeleri bekletti.
- Agent log’larının tamamı controller’ın diskini doldurdu.
Agent skill optimizasyonu için uzun bir search planlıyorsanız bu iki noktayı baştan tasarlayın. Latency kontrolüne bir üst bekleme süresi tanımlayın ki yavaş bir model penceresi search’ü sonsuza kadar durdurmasın. Log’ları controller diskinde biriktirmek yerine harici depolamaya taşıyın veya yalnızca başarısız denemelerin tam log’unu saklayın. Çalışma sürerken controller diskini düzenli kontrol edin:
df -hKurumsal harness’larda ilk sonuçlar
Google aynı yöntemi system prompt, policy talimatları ve tool’lardan oluşan kurumsal agent harness’larında deniyor. Kurgusal bir bankanın müşteri hizmetleri test vakalarında AlphaEvolve, bilerek yerleştirilen yanlış bir policy kuralını buldu, düzeltti ve düzeltmeyi hiç görmediği vakalara da taşıdı. Diğer küçük çalışmaların sonuçları karışık çıktı; Google tam çalışmayı bitirmeden bu bulguyu genelleştirmeyin.
Başlangıç için GitHub’daki AlphaEvolve repo’su, Terminal-Bench 2.0 ile Harbor ve agentskills.io’daki skill formatı yeterli. Agent skill optimizasyonu denemesinden önce baseline skill’inizi skill’siz çalışmayla karşılaştırın; fark çıkmıyorsa optimize edilecek ilk şey skill’in içeriği.