MongoDB replica set için sharding yerine tiering: Thermocline PoC
Thermocline, bellekten taşan bir MongoDB replica set önüne küçük bir hızlı katman koyarak sharding'e gerek kalmadan okuma yükünü azaltmayı deniyor.
Bu haberde
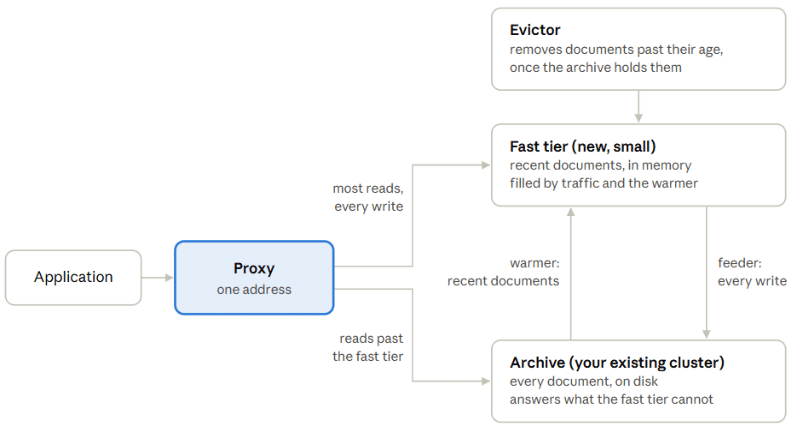
Thermocline adlı açık kaynak PoC (Proof of Concept), belleğe sığmayan bir MongoDB replica set önüne doküman yaşına göre çalışan küçük bir hızlı katman koyuyor ve uygulamayı bir proxy üzerinden iki katmana bağlıyor. Hetzner Cloud üzerindeki testte 1 GB WiredTiger cache ile 47 GB veri tutan aynı cluster, Thermocline arkasında saniyede 1,6 ile 5,2 kat daha fazla işlem yaptı. Proje Apache 2.0 lisanslı ve henüz production’da çalışmadı.
MongoDB replica set nedir, ne işe yarar?
MongoDB replica set, aynı veriyi tutan birden çok mongod sürecinden oluşan gruptur. Bir primary üye yazmaları alır, secondary üyeler verinin kopyasını tutar ve primary düştüğünde aralarından biri seçilerek failover yapılır. Yüksek erişilebilirlik ve okuma dağıtımı için kullanılır. Veri tek bir üyenin kapasitesini aştığında bilinen alternatif, veriyi shard key’e göre birden çok replica set’e bölen sharded cluster yapısıdır.
MongoDB replica set için asıl sorun eski veri
Bellekten taşan bir MongoDB replica set için bilinen iki çıkış var: daha büyük makine ya da sharding. Thermocline üçüncü bir yol deniyor. Okumaların çoğu son veriye gidiyorsa eski veri cache’i boşuna işgal ediyor. Çözüm de onu kenara itmek.
Sharding’in bedeli bilinir: sonradan değiştirmesi zor shard key, mongos router’ları, config server’lar, balancing ve shard key olmadan yavaşlayan sorgular. Thermocline’da uygulama tarafında değişen tek şey bağlantı adresi. Uygulama eski cluster yerine proxy’ye bağlanıyor.
Dört parça, iki katman
Mantık bir mağazanın vitrini ile deposuna benziyor. Çok satan ürün vitrinde durur, ama depo her zaman tam stok tutar.
- Proxy: MongoDB wire protocol konuşuyor. Hızlı katman cevabın tamamını tuttuğunu kanıtlayabiliyorsa sorgu oraya, kanıtlayamıyorsa archive’a gidiyor. Yazmalar hızlı katmana düşüyor.
- Feeder: hızlı katmanın change stream’ini okuyup her yazmayı archive’a kopyalıyor.
- Evictor: koleksiyonun yaş eşiğini geçen ve archive’da olduğu doğrulanan dokümanı hızlı katmandan siliyor.
- Warmer: eşikten yeni dokümanları archive’dan hızlı katmana çekiyor.
Elle veri taşıma yok. Eski cluster olduğu gibi archive’a dönüşüyor.
İş yükünüz bu modele uyuyor mu?
Kazanç tamamen okuma dağılımına bağlı. En iyi sonuç, aktivitenin yüzde 99’u en yeni yüzde 9’luk dokümanlara yoğunlaştığında geldi: 4.447’den 23.340 işlem/saniyeye, read p95 86 ms’den 6 ms’ye. Mağaza karışımında oran 1,6 katta kaldı. Okumalar tüm geçmişe eşit dağılıyorsa kazanç az.
Her MongoDB replica set bu modele uymaz. Karar vermeden önce üç şeye bakın:
- Veri boyutu ile WiredTiger cache arasındaki oran. Test yaklaşık 47 kat farkla yapıldı.
- Data disk’inin IOPS sınırına dayanıp dayanmadığı. Testteki 70 ms p95’in nedeni kötü index değil, sınıra dayanmış diskti.
- Okumaların ne kadarının yakın tarihli dokümanlara gittiği.
İlk ikisi için hızlı bir bakış:
mongosh --quiet --eval 'db.serverStatus().wiredTiger.cache["maximum bytes configured"]'
mongosh --quiet --eval 'db.serverStatus().wiredTiger.cache["bytes currently in the cache"]'
iostat -x 5
Üçüncüsü için sorgu log’larına bakmak gerekiyor. Tarih alanını son günlere göre filtreleyen sorguların oranı iyi bir başlangıç noktası.
Yazma ağırlıklı yüklerde beklentiyi düşük tutun
Her yazma archive’a da gidiyor. Bir update’i yansıtmak için archive o dokümanı önce diskten okuyor. Mağaza karışımında update’ler eski cluster’ın hızında kaldı, update p99 ise 104-189 ms’den 455-472 ms’ye çıktı. Yazar bu kuyruk gecikmesi üzerinde çalıştığını söylüyor.
Yani darboğazınız yazma IOPS’uysa Thermocline sorunu çözmüyor. Update tail latency’ye duyarlı bir uygulamada durumu kötüleştirebilir.
Test ederken bakılacak bir nokta daha var. Kaynak, feeder geride kaldığında archive’a giden sorguların ne gördüğünü ayrıntılandırmıyor. Eski ve yeni veriyi birlikte tarayan bir rapor sorgusu archive’a düşüyorsa, feeder gecikmesi o sorgunun sonucuna yansıyabilir.
Denemeden önce
- İki katman aynı MongoDB sürümünü çalıştırmak zorunda. Archive, uygulamanın sorgularına doğrudan cevap veriyor. Eski bir cluster’ı archive yapacaksanız önce onu yükseltmeniz gerekiyor; iki tarafta
db.version()çıktısını karşılaştırın. - Proje bir PoC. Geniş bir test paketi var ama production’da çalışmadı ve yazar gerçek trafiği yönlendirmemeyi açıkça söylüyor.
- Proxy, uygulama ile veritabanı arasına yeni bir hop ve işletilecek yeni bir bileşen ekliyor. Kaynak proxy’nin yüksek erişilebilirlik kurgusunu anlatmıyor. Staging’de proxy’yi düşürüp uygulamanın nasıl davrandığını görmek ilk testlerden biri olmalı.
- Hızlı katman boş başlıyor. Testte eski cluster’ın değerini 100 saniyede geçti ve 30 dakikada 271.271 doküman archive’dan yukarı kopyalandı. Bu ısınma sırasında warmer’ın archive’dan okuma yaptığını kapasite planına katın.
Kod github.com/zelmario/thermocline adresinde, README çalıştırma adımlarını anlatıyor. Yazarın sayıları kendi test cluster’ından geliyor. Kendi trafiğinizin bir kopyasıyla staging’de ölçmeden bu oranları beklemeyin.